Je stak uren in de perfecte lay-out van je cv, uploadde het naar een vacatureportaal, en de automatisch ingevulde preview kwam eruit als door elkaar gehaspelde tekst, met je contactgegevens verdwenen. Wat ging er mis? Cv-parsing.
Cv-parsing is het geautomatiseerde proces waarbij software een cv leest en de informatie uitleest tot gestructureerde, machine-leesbare velden: naam, contactgegevens, werkervaring, titels, datums, vaardigheden en opleiding. Het programma dat dit doet is een cv-parser, en het verandert je document in geordende data die een ATS (sollicitatievolgsysteem) kan opslaan, doorzoeken en rangschikken.
Dit begrijpen verklaart waarom een prachtig cv als onzin kan overkomen op een machine, en hoe je dat voorkomt. Parsen is één stap in de grotere ATS-pijplijn; voor de hele flow, zie hoe een ATS werkt.
De korte versie
- Parsen leest je cv uit tot datavelden die een machine kan lezen en doorzoeken.
- Het leest de onderliggende tekst in codevolgorde, niet de visuele volgorde die jij ziet.
- Tabellen, kolommen, kop-/voetteksten en afbeeldingen zijn wat het verhaspelt.
- Een slechte parse wijst je zelden automatisch af, maar begraaft je data zodat je laag ranket.
- Gebruik een enkele kolom, tekstgebaseerd cv zodat het schoon wordt ingelezen.
Hoe een cv-parser werkt (stap voor stap)
Volg je bestand door de parser:
- 1
Binnenkomst
Je bestand (pdf, docx, enzovoort) wordt handmatig of via een vacaturesite ingediend.
- 2
Tekstextractie
De parser haalt de platte tekstlaag uit het bestand, en afbeeldingen en decoratieve opmaak worden gestript.
- 3
OCR (alleen indien nodig)
Voor gescande of afbeeldinggebaseerde cv's zet optische tekenherkenning pixels om in tekst. Deze stap is foutgevoelig.
- 4
Normalisatie
Kop- en voetteksten, kolommen en tabellen worden geplet, en datums en regeleinden gestandaardiseerd.
- 5
NLP en veldtoewijzing
Taalmodellen herkennen entiteiten (namen, werkgevers, titels, datums, vaardigheden) en wijzen ze toe aan de juiste velden.
- 6
Gestructureerde output
Het resultaat wordt weggeschreven als een gestructureerd record (vaak JSON of XML) en opgeslagen in de ATS-database voor recruiters om te doorzoeken.
Hier is het inzicht dat bijna elke parse-fout verklaart: de parser leest codevolgorde, niet visuele volgorde. Als de visuele volgorde van je lay-out niet overeenkomt met de onderliggende tekstvolgorde, krijg je door elkaar gehaspelde data.
Zie wat een parser echt eruit haalt
Benieuwd wat de machine van je cv afleest? Onze gratis Keyword Scanner leest je cv uit zoals de software dat doet en toont je precies welke velden het vond, zodat je een verhaspelde parse opspoort voordat je verder leest in deze gids.
Hoe geparste cv-data eruitziet
Na de stappen hierboven wordt je pagina-document een gestructureerd record. Ongeveer zo (vereenvoudigde JSON):
Velden die een parser eruit haalt
- Contactgegevens: naam, e-mail, telefoon, locatie, LinkedIn/portfolio-links
- Werkervaring: werkgever, functietitel, begin-/einddatum, omschrijvingen
- Opleiding: school, diploma, datums
- Vaardigheden
- Certificeringen en talen (vaak)
Elk daarvan wordt een apart, doorzoekbaar veld. Een recruiter kan filteren op “Python” bij vaardigheden of “2+ jaar” dienstverband en jouw record matcht wel of niet. Kan een veld niet gevonden worden, omdat het vastzit in een tabel of een afbeelding, dan komt dat veld leeg terug, en lijk je minder gekwalificeerd dan je bent.
Hoe nauwkeurig zijn cv-parsers?
Moderne parsers zijn goed, op schone bestanden. Onafhankelijke benchmarks zetten de besten ruim boven 90% op de standaard nauwkeurigheidsmaat.
nauwkeurigheid van toonaangevende cv-parsers op schone, goed opgemaakte cv's
Precisie en recall liggen doorgaans beide boven 90% in onafhankelijke tests. De nauwkeurigheid daalt sterk bij tabellen, kolommen en gescande bestanden.
Source: Industrie-parserbenchmarks, 2024
Dat cijfer is wel de adder onder het gras. De 90%-plus nauwkeurigheid gaat uit van een schoon, tekstgebaseerd cv met één kolom. Voer dezelfde parser een tweekolomstemplate met iconen en een logo, en de nauwkeurigheid kan instorten, waarbij juist de velden die recruiters doorzoeken wegvallen of verhaspelen. De techniek is zelden het probleem. Je opmaak is de variabele die jij in de hand hebt.
Wijst een slechte parse je automatisch af?
Dit is de angst achter het hele onderwerp, dus laten we het direct ontkrachten: een cv-parser verwijdert je sollicitatie niet stilletjes.
van de recruiters zegt dat hun ATS cv's automatisch afwijst
De andere 92% vertrouwt op menselijke beoordeling, gestuurd door knock-outvragen, niet op automatische afwijzing.
Source: Enhancv recruiter survey, 2025
Het realistische risico is stiller dan afwijzing. Een slechte parse verstrooit je data, dus de matchstap scoort je laag en je zakt naar de onderkant van een lange gerangschikte lijst. Geen mens leest je ooit goed. De uitzondering zijn knock-outvragen (werkvergunning, een verplicht diploma, minimum aantal jaren), die je automatisch kunnen wegfilteren, maar dat doet het sollicitatieformulier, niet de parser die je bullets verkeerd leest. Voor het volledige plaatje, zie hoe een ATS werkt en wat een goede ATS-score echt is.
Keyword-parsing vs context-parsing
Oudere parsers matchten exacte tekstreeksen. Moderne gebruiken natuurlijke taalverwerking om betekenis en verbanden te begrijpen, en herkennen dat “leidde een team van 8” duidt op leidinggeven, of dat “JS” “JavaScript” betekent.
Wat dit voor jou betekent
Je hebt nog steeds de juiste keywords nodig (de zoekstap is letterlijk), maar contextbewust parsen betekent dat natuurlijke formulering het volstoppen met keywords verslaat. Schrijf echte zinnen met echt bewijs, en zet zowel de volledige term als de afkorting erin, zoals “Search Engine Optimization (SEO)”, zodat je op beide matcht. Onze gids voor keywords extraheren uit vacatures behandelt hoe je ze kiest zonder te stapelen.
Waarom opmaak het parsen breekt
Deze veelgemaakte keuzes verpesten je data stilletjes:
Opmaak die een parser verhaspelt
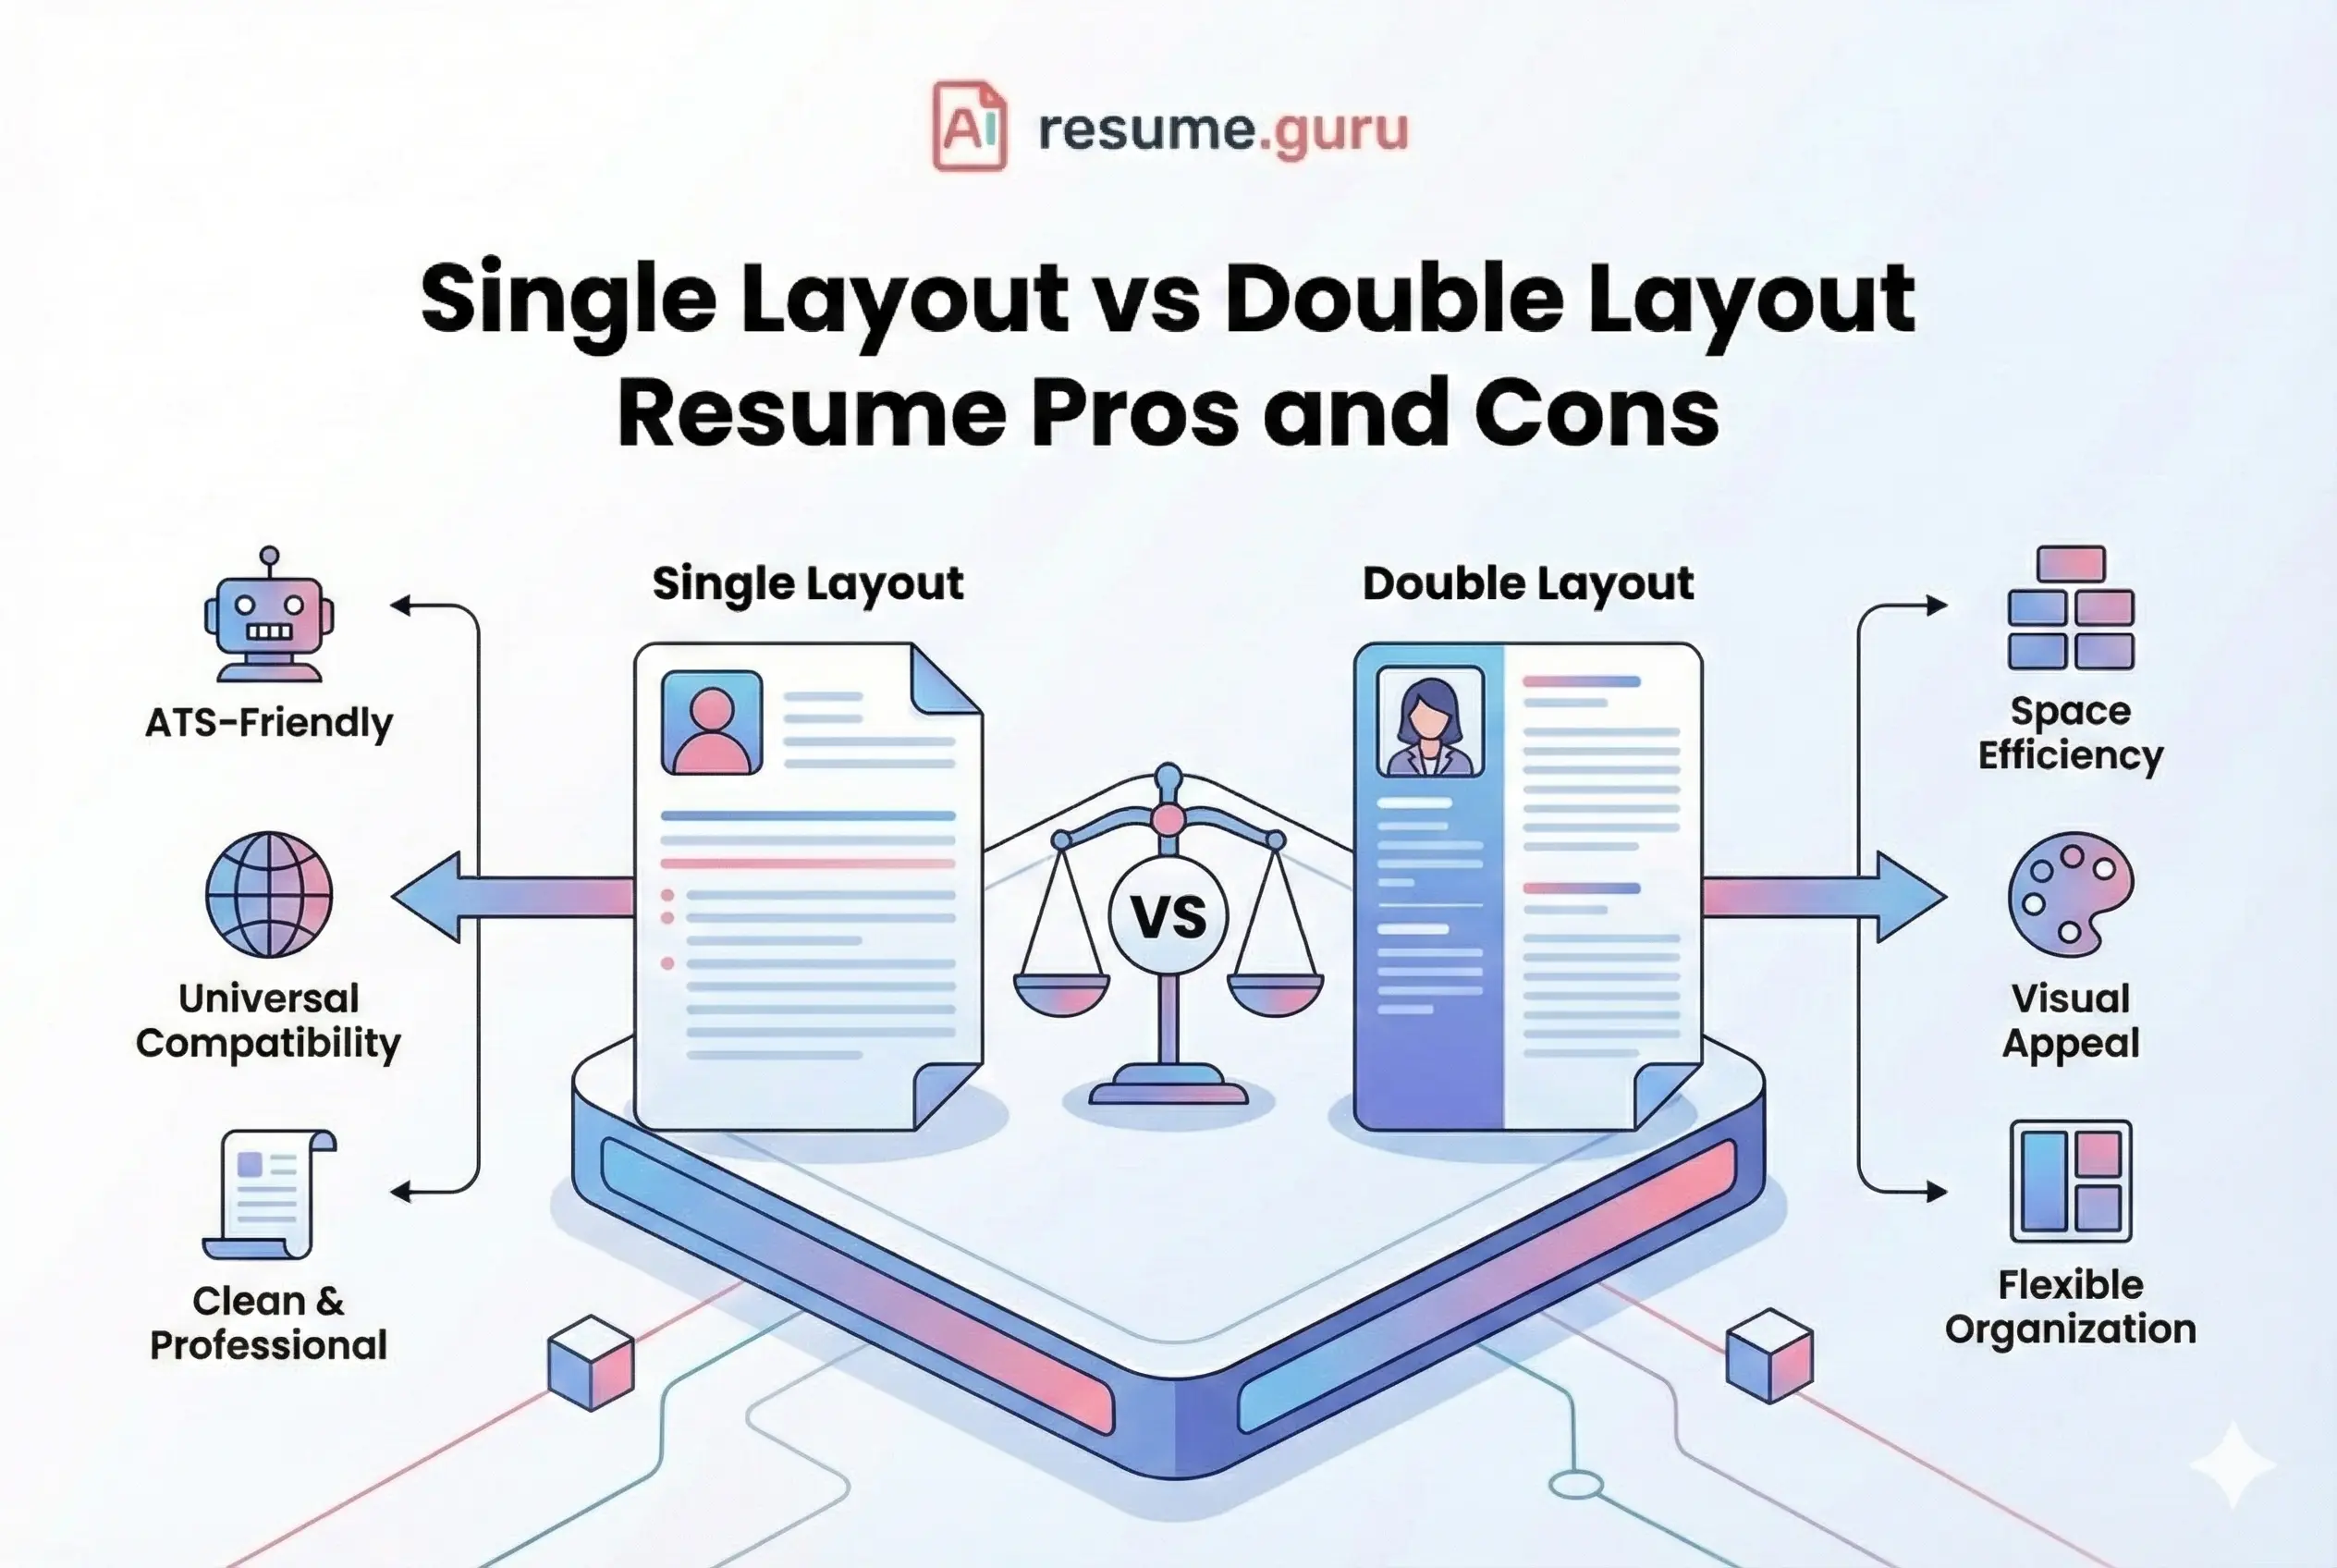
- Tabellen en kolommen worden over de rij gelezen in plaats van cel voor cel, waardoor inhoud door elkaar raakt
- Kop- en voetteksten worden vaak overgeslagen, dus contactgegevens die daar staan gaan verloren
- Tekst in afbeeldingen of graphics is onzichtbaar voor de parser zonder OCR
- Gescande of afbeelding-pdf’s hebben geen extraheerbare tekst, en OCR voegt fouten toe
- Niet-standaard lettertypen en speciale tekens kunnen verkeerd renderen of niet worden toegewezen
- Lay-outs uit ontwerptools (Canva, Illustrator) hebben een gelaagde, niet-lineaire structuur die verhaspelt bij het pletten
Voor het complete opmaakboek, zie onze gids voor een ATS-vriendelijk cv-format, en voor lettertypekeuzes die het parsen overleven, onze lijst met ATS-vriendelijke cv-lettertypen.
Bullet points, symbolen en speciale tekens
Twee van de meest voorkomende, minst voor de hand liggende parse-fouten schuilen in je bullet points en je leestekens.
Bullet-symbolen. Een standaard ronde bullet of een liggend streepje wordt schoon geparset. Decoratieve bullets (sterren, pijlen, vinkjes, vierkante iconen) zijn geen standaard tekst, dus een parser kan het symbool laten vallen of, erger, twee bullets samenvoegen tot één doorlopende regel en de scheiding tussen je prestaties verliezen. Wil je sterke, parse-veilige bullets, zie dan onze gids over cv bullet points.
Speciale tekens. Symbolen kunnen een veld afkappen. Een klassieke fout is het ampersand: “Jansen & Co.” kan parsen als alleen “Jansen”, omdat de parser het ”&” als veldgrens behandelt. Schuine strepen, verticale strepen en decoratieve streepjes veroorzaken vergelijkbare afkappingen midden in een veld.
Snelle fixes voor symbool-afkapping
- Schrijf “en” voluit in plaats van & in werkgever- of sectienamen.
- Gebruik een gewone ronde bullet of liggend streepje, nooit icoon-bullets of emoji.
- Vermijd verticale strepen (|) als scheidingsteken in je contactregel; gebruik gewone spatiëring of komma’s.
- Houd leestekens simpel: punten, komma’s, haakjes en gewone streepjes zijn veilig.
Onze diepere uitleg over speciale tekens en het ATS somt op welke symbolen veilig zijn en welke je laat vallen.
Waarom datumnotaties parsers laten struikelen
Parsers normaliseren datums om te berekenen hoe lang je elke rol hield. Mix stijlen op één cv, zoals “maart 2023” in de ene baan en “03-2023” in de andere, en die logica kan breken, je dienstverband verkeerd tellen of een datum helemaal niet lezen. Soms leest een parser een datum zelfs als onderdeel van je functietitel.
Kies één notatie en gebruik die overal. “mmm jjjj” (bijvoorbeeld “mrt 2023”) is het veiligste, breedst geparste patroon. Onze gids voor cv-datumnotaties toont de patronen die betrouwbaar parsen en die je moet vermijden.
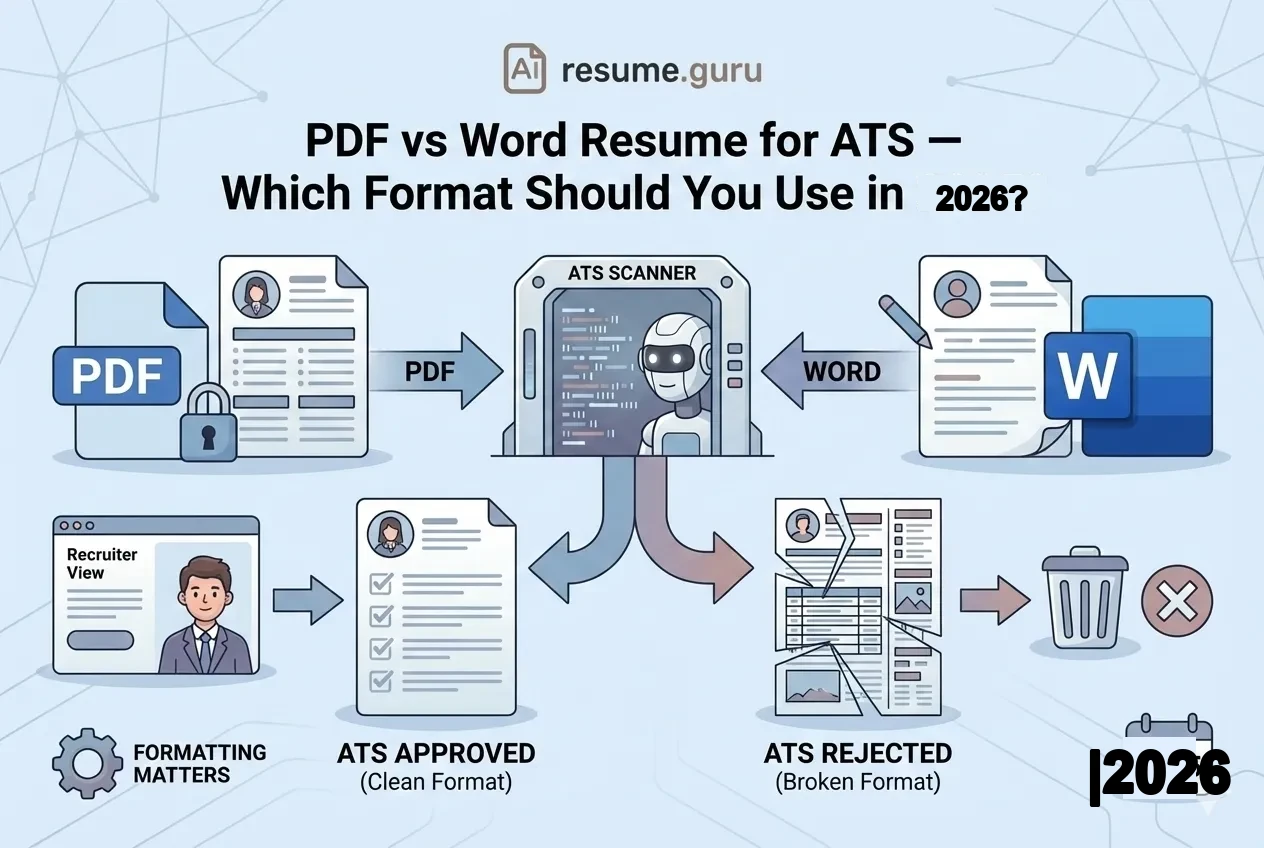
Pdf vs Word voor parsen
De scheidslijn die telt is niet pdf versus Word, het is tekstgebaseerd versus afbeeldinggebaseerd:
| Formaat | Hoe het parset |
|---|---|
| Tekstgebaseerde pdf | Parset goed in de meeste moderne systemen en behoudt opmaak |
| Word (.docx) | Veilige keuze, soms gevraagd, maar sommige systemen verwerken complexe tabellen slecht |
| Gescande / afbeelding-pdf | Worst case: onleesbaar zonder foutgevoelige OCR |
De regel: een schoon, enkelkoloms, tekstgebaseerd bestand in het formaat dat de vacature vraagt. Standaard pdf tenzij Word wordt gevraagd, en nooit een gescande afbeelding. Voor de volledige vergelijking en wanneer elk wint, lees pdf vs Word cv.
Hoe maak je je cv machine-leesbaar
- 1
Gebruik een enkele kolom
Geen tabellen, kolommen of tekstvakken, zodat de parser van boven naar beneden leest.
- 2
Houd contactgegevens in de body
Niet in de kop- of voettekst, en niet in een afbeelding.
- 3
Sla op als tekstgebaseerd bestand
Exporteer een echte pdf of docx, nooit een gescande afbeelding. Match het gevraagde formaat van de vacature.
- 4
Gebruik standaard kopjes
'Werkervaring', 'Opleiding', 'Vaardigheden', zodat velden goed worden toegewezen.
- 5
Gebruik standaard lettertypen en gewone bullets
Sla iconen, graphics, tekst-in-afbeeldingen en decoratieve bullet-symbolen over.
- 6
Zet vaardigheden als platte tekst
Gescheiden door komma's of bullets, niet in een tabel, met één consistente datumnotatie overal.
- 7
Controleer de parse vóór je solliciteert
Draai je cv door een scanner en bevestig dat elk veld er goed uitkwam.
Vang parse-problemen, repareer ze dan bij de bron
Onze gratis Keyword Scanner leest je cv zoals de software dat doet en matcht het tegen een vacature, zodat je verhaspelde inhoud of verborgen keywords opvangt voordat een recruiter dat doet. Toont de scan ontbrekende of door elkaar gehaalde velden, bouw dan opnieuw op een parse-schoon fundament: de AI cv-bouwer en onze enkelkoloms ATS-veilige templates leveren standaard schone, tekstgebaseerde bestanden, zodat de volgende scan intact terugkomt.
De conclusie
Cv-parsing is de onzichtbare eerste lezer van je sollicitatie. Het kan je niets schelen hoe mooi je lay-out is, alleen of het je data schoon kan extraheren. Het wijst je niet stilletjes af, maar een rommelige parse kan je zo in de rangschikking begraven dat geen mens je goed leest. Houd je cv enkelkolom en tekstgebaseerd, zet je informatie in platte tekst waar de parser het verwacht, gebruik één datumnotatie, en controleer het resultaat voordat je solliciteert. Komt je cv steeds verhaspeld terug, dan is dat vaak de echte reden dat je cv geen gesprekken oplevert.
Krijg het parsen goed, en de rest van het sollicitatieproces krijgt jou eindelijk te zien.
Controleer hoe je cv parset
Draai je cv door onze gratis Keyword Scanner om precies te zien wat een parser eruit haalt en wat ontbreekt, nog vóór je op Solliciteer klikt.
Probeer de Keyword ScannerGerelateerde bronnen
- Keyword Scanner — Zie precies hoe je cv wordt geparset
- Hoe werkt een ATS? — De volledige pijplijn van de wervingssoftware
- ATS-vriendelijk cv-format — Het complete opmaakboek
Veelgestelde vragen
Wat is cv-parsing?
Cv-parsing is het geautomatiseerde proces waarbij software een cv leest en de informatie uitleest tot gestructureerde, machine-leesbare velden zoals naam, contactgegevens, werkervaring, functietitels, datums, vaardigheden en opleiding. Het programma dat dat doet is een cv-parser. Het verandert je document in geordende data die een ATS (sollicitatievolgsysteem) kan opslaan en doorzoeken.
Hoe werkt een cv-parser?
Een parser leest je bestand in, haalt de platte tekst eruit, draait OCR als het bestand een afbeelding is, en plet dan tabellen en kolommen. Het gebruikt natuurlijke taalverwerking om entiteiten (namen, werkgevers, datums, vaardigheden) te herkennen en aan velden toe te wijzen. Het resultaat is een gestructureerd record in de ATS-database dat recruiters doorzoeken.
Wijst cv-parsing mijn cv automatisch af?
Nee. Slechts 8% van de recruiters zegt dat hun ATS cv's automatisch afwijst; 92% vertrouwt op menselijke beoordeling, gestuurd door knock-outvragen, niet op stille verwijdering (Enhancv, 2025). Een slechte parse gooit je sollicitatie niet weg, maar kan je data zo begraven dat je laag ranket en een recruiter je sterkste punten nooit ziet.
Hoe nauwkeurig zijn cv-parsers?
Toonaangevende parsers halen meer dan 90% F1-scores (precisie en recall beide boven 90%) op schone, goed opgemaakte cv's in onafhankelijke benchmarks (industrie-parserbenchmarks, 2024). De nauwkeurigheid daalt snel bij tabellen, kolommen, graphics en gescande bestanden. Schone opmaak is de grootste factor die je zelf in de hand hebt.
Welke informatie haalt een cv-parser eruit?
Contactgegevens (naam, e-mail, telefoon, locatie, links), werkervaring (werkgever, titel, datums, omschrijvingen), opleiding (school, diploma, datums), vaardigheden, en vaak certificeringen en talen. Elk veld wordt apart herkend en opgeslagen, zodat recruiters kandidaten op elk ervan kunnen doorzoeken en filteren.
Waarom ziet mijn cv er door elkaar gehaspeld uit in het ATS?
Omdat de parser de onderliggende tekst in codevolgorde leest, niet de visuele volgorde die jij ziet. Tabellen, meerkolomslay-outs, tekstvakken en kop- of voetteksten laten de parser inhoud buiten volgorde lezen of overslaan. Dat haspelt je data door elkaar of laat velden zoals je contactgegevens helemaal vallen.
Waarom breekt het ATS mijn bullet points?
Eigen bullet-symbolen, iconen en tekens zijn geen standaard teksttekens, dus de parser kan ze laten vallen of twee bullets samenvoegen tot één doorlopende regel. Houd het bij een gewone ronde bullet of een liggend streepje. Vermijd sterren, pijlen, vinkjes en emoji, die vaak verdwijnen of de regel erna verminken.
Kan een cv-parser speciale tekens en symbolen lezen?
Standaard letters, cijfers en basisleestekens worden prima gelezen. Symbolen zoals het ampersand, lange streepjes, schuine strepen en decoratieve tekens kunnen een veld afkappen of verhaspelen. Een werkgever geschreven als 'Jansen & Co.' kan parsen als 'Jansen'. Schrijf 'en' voluit en houd leestekens simpel om afkappen midden in een veld te voorkomen.
Waarom brengt mijn datumnotatie de cv-parser in de war?
Parsers normaliseren datums om je dienstverband te berekenen, dus stijlen mixen zoals 'maart 2023' en '03-2023' op één cv kan die logica breken en je ervaring verkeerd tellen. Kies één notatie, meestal 'mmm jjjj', en gebruik die overal. Zie onze gids over cv-datumnotaties voor de veiligste patronen.
Leest cv-parsing pdf of Word beter?
De echte scheidslijn is tekstgebaseerd versus afbeeldinggebaseerd, niet pdf versus Word. Een tekstgebaseerde pdf geëxporteerd uit een bouwer of tekstverwerker wordt goed ingelezen in de meeste moderne systemen. Word is een veilige keuze en wordt soms gevraagd. Vermijd gescande of afbeelding-pdf's, die foutgevoelige OCR nodig hebben. Stuur het formaat dat de vacature vraagt.
Waarom parset mijn cv prima maar scoort het laag?
Parsen en matchen zijn twee stappen. De parser kan elk veld perfect uitlezen, terwijl de matchstap je toch laag scoort als je formulering de keywords van de vacature mist. Schoon parsen is noodzakelijk maar niet voldoende. Je hebt ook de juiste termen uit de vacature nodig in je echte inhoud.
Breng dit in de praktijk
De theorie heb je. Dit kost een paar minuten en werkt met het cv dat je al hebt.